Windows 本地语音输入法:按住说话,忠实纠错,保守提交
从按住说话的录音边界,到 Windows 本地 CPU 推理,建立一套忠实、低延迟、可撤销的语音输入架构。解释 ASR、词典规则、MacBERT4CSC 和轻量 LLM 的职责,给出中英混说的字符保护策略,并依据官方文档与源码厘清 SenseVoice、sherpa-onnx 和 FunASR 的热词支持边界。
Windows 本地语音输入法:按住说话,忠实纠错,保守提交
作者:Ha Fung
技术资料核查日期:2026 年 10 月 10 日

写技术说明时,手离开键盘,说一句“把 PostgreSQL 的索引优化一下”,松开快捷键,文字出现在原来的光标处。这个动作能否成为日常习惯,取决于三个很具体的结果:第一声有没有录全,松手后多久能继续输入,专业名词有没有写对。
我的选择是把语音输入法做成一个忠实的输入工具:ASR 负责听清,词典和规则处理确定的错误,CSC(中文拼写纠错)模型按需加入,每次自动修改都受边界约束。润色可以作为用户主动调用的编辑功能。默认输入应保留说话人的措辞、语气和判断。
快捷键的重点在于控制录音边界
桌面语音输入常见的交互可以归为两种:按住说话、松手结束;按一次开始、再按一次结束。前者适合几秒钟的短句、聊天回复和技术备注,手指直接掌握录音区间。后者适合较长的叙述,能减轻持续按键的负担。两种模式值得共用一条识别管线,让用户按自己的动作习惯切换。
Windows 自带语音键入通过 Win + H 调出界面。微软将它描述为使用在线语音识别的功能,使用条件包括互联网连接、麦克风和文本框中的光标。这是理解系统入口的起点。微软语音键入与隐私说明
自己实现按住说话时,我建议提供可配置的组合键,例如把 Ctrl + Alt + Space 作为候选,安装时检查系统和常用应用的占用情况。右 Ctrl、右 Alt 等单键可以放进高级设置,同时测试输入法切换、AltGr 布局和原有键义。具体按键由冲突检测和用户习惯决定。
Windows 的 RegisterHotKey 提供全局热键触发,MOD_NOREPEAT 可以抑制长按产生的重复通知。按住说话还需要明确观察按下与释放事件;应用可用键盘钩子或键状态机制完成这部分工作,并把耗时识别放进工作线程。微软文档同时指出,带 Windows 键的组合快捷键属于操作系统保留范围。RegisterHotKey 文档
交互实现里有四个细节直接影响手感:
- 按下后给出即时录音反馈。使用已获授权的短音频环形缓冲,可以覆盖设备启动时丢失的开头;缓存范围、保存方式和录音状态应清楚可见。
- 松手后封存当前音频,马上结束这一轮采集。VAD,也就是语音活动检测,负责静音过滤和长句切段;显式按键事件负责这次输入的起止。
- 记录本轮目标窗口,提交前重新检查焦点。焦点变化时,将结果放入候选区供用户选择目标,避免把文字送进刚切换的聊天框。
- 提供 Esc 取消、整次输入撤销和原始转写查看。一次说话形成一次提交,用户能迅速恢复到修改前的状态。
键盘上的一个动作,背后其实是一笔输入事务:录音、识别、修正、确认目标、提交。把事务边界做清楚,比增加一个“智能”按钮更能提升可靠性。
ASR 听声音,纠错判断文字
ASR 是自动语音识别。它接收音频,结合声学信息和模型学到的语言规律,生成文字。自动纠错通常接收识别后的文本,依据词典、字词关系或上下文提出替换。前者有声音证据,后者的判断主要来自文字。
这一区别决定了错误应在哪一层处理。麦克风削掉了开头、背景噪声盖住了一个词,优先改善采集和识别。“索引”被输出为“所引”,可以用确定的领域映射或中文纠错候选处理。输出整段漏了“索引”,单靠文本后处理补回这个词需要更强的证据。
还有一层是显示格式:标点、空格、数字格式,以及 ITN(逆文本规范化,例如把读出的数字变成书写形式)。它影响可读性,也会改变版本号、日期和数值的呈现,适合单独配置。SenseVoice 的公开实现提供 use_itn 选择;应用应分别评估开启和关闭后的技术口述结果。SenseVoice 公开推理代码
因此,“自动纠错”应该落实为可解释的修改记录。例如:
ASR 原文:把 PostgreSQL 的所引优化一下。
规则候选:所引 → 索引
最终提交:把 PostgreSQL 的索引优化一下。
依据:当前数据库词典中的已确认映射
这里的数据库场景和映射属于架构示例,实际产品需要用自己的录音确认它的适用范围。
忠实输入让用户保有表达权
考虑这样一段口述:
呃,那个 PostgreSQL 的索引,我觉得,我们应该先用 MySQL,我更正一下,是 PostgreSQL,先优化一下查询。
这句话带着犹豫、建议语气和一次自我更正。“我觉得”让它听起来像讨论中的意见;“我们应该”表达建议;从 MySQL 更正为 PostgreSQL 的措辞保留了说话过程。这些内容都可以构成用户希望输入的信息。
如果输出变成“PostgreSQL 的索引,我们应该先优化一下查询”,系统已经完成了语句编辑。对需要保存原话的人来说,核对任务随之扩大:他要检查事实、语气、删掉的内容,以及模型对意图的解释。输入工具的收益被额外校对成本抵消。
我推荐把产品分成两个明确动作:语音输入默认忠实提交;用户选中文本后主动调用整理。 在输入阶段,错字替换、术语规范和标点各自有开关,口头禅与自我更正默认保留。整理阶段可以提供删赘词、改写等编辑操作,并展示结果。
同样的边界也适用于“忠实”本身。ASR 模型的训练目标、解码方式与文本规范化设置会影响口语细节。产品需要拿真实的重复、停顿和自我更正录音做验证,建立自己可承诺的保真程度。
Windows 本地 CPU 可以采用怎样的架构
对于希望安装包轻、运行时使用 CPU、用户机器免装 Python 和 PyTorch 的 Windows 工具,我推荐从 C#/.NET 桌面外壳 + sherpa-onnx + SenseVoice-Small 的预转换模型 + 本地规则词典 起步。偏向 C++ 的团队可通过 sherpa-onnx 的 C/C++ 接口接入同样的识别核心。
sherpa-onnx 用 ONNX Runtime 执行神经网络,官方说明识别在设备本地完成,并提供 Windows 部署路线。C# 接口支持流式和非流式识别,提供 NuGet 包与预编译库。sherpa-onnx 部署说明、C# 接口
SenseVoice-Small 是一个支持中文、粤语、英语、日语和韩语的识别候选。sherpa-onnx 提供相应预训练模型和 int8 版本,可以用实际录音比较精度与速度。SenseVoice 模型入口
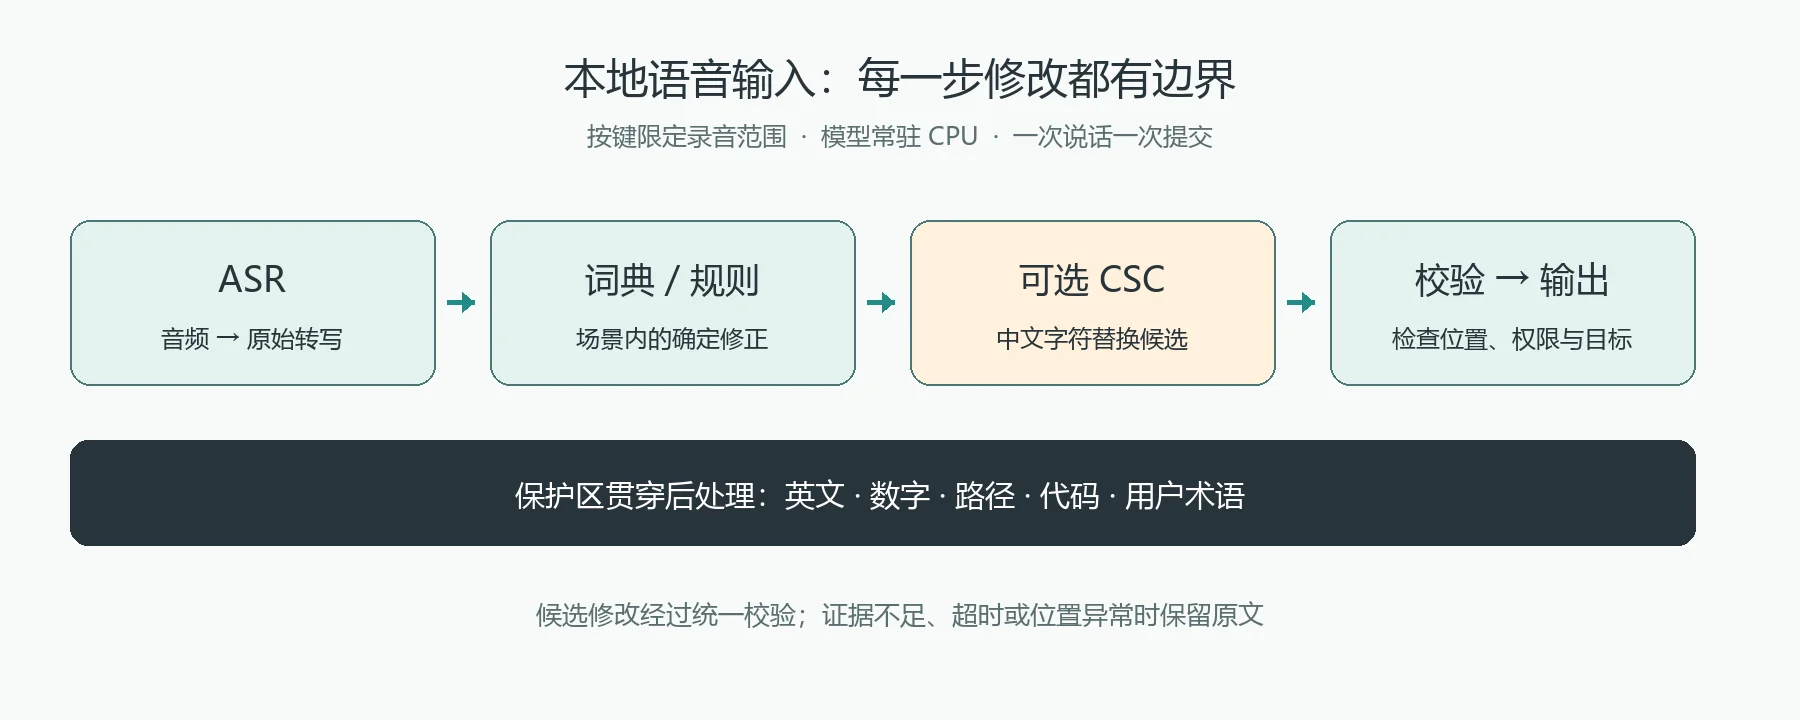
图中的“保护”贯穿文字处理阶段。词典与模型都输出带位置的候选修改,由提交前的统一校验决定哪些修改进入结果。
运行时可以随应用分发本机库、模型、词表、配置和词典。训练、导出或准备模型可以放在开发环境;用户电脑只承担音频采集与推理。这里的“Windows 原生”指原生桌面应用及本地推理,具体识别能力由随应用交付的模型提供。
第一版适合按句识别:用户说完短句,松手后执行一次非流式推理。长段口述可以用 VAD 切分,同时保留上下文与片段边界。如果产品需要边说边出现稳定文字,再选择原生流式模型,例如合适的中英双语 Transducer,并独立评估延迟、术语命中率和流式修订行为。
SenseVoice 的分块调用可以做出持续更新的预览。此类预览有自己的上下文与重算成本,应当作为单独的工程方案测试;部分结果先留在预览区,最终结果再提交,能减少用户正在编辑时发生的回改。
把识别结果送入其他应用也需要认真设计。原型可用 Unicode SendInput 或受控的剪贴板粘贴,兼容性分别验证。微软说明 SendInput 受 UIPI 完整性级别约束,只能向同等或较低完整性级别的应用注入输入。需要成熟的系统输入法体验时,可以进一步评估 TSF 的组合文本与提交接口。SendInput 文档
低延迟来自整条管线。模型常驻和预热减少冷启动,合理的线程数减轻前台应用争用,异步推理保持录音与界面响应,超时后的原文提交提供稳定退路。CPU 型号、音频长度、量化和线程设置都会改变结果;最终以目标电脑上“松手到文字落入输入框”的 P50/P95 延迟作为体验指标,分别观察典型等待与较慢的那部分请求。
词典、MacBERT4CSC 和轻量 LLM:按修改权限选工具
| 方案 | 最有价值的用途 | 工程代价与约束 | 我的定位 |
|---|---|---|---|
| 词典与规则 | 已确认术语、常见混淆、大小写规范 | 需要维护词条、边界和场景范围 | 默认开启,先做这一层 |
| MacBERT4CSC | 中文上下文中的拼写替换候选 | 增加模型、分词与对齐成本,需要领域评测 | 可选开启,自动修改范围受限 |
| 轻量 LLM | 更复杂的上下文判断、主动整理 | 增加内存和生成延迟,需要严格输出校验 | 用户主动调用,或仅给候选 |
词典的优势是错误来源清楚。例如数据库场景下,把经过录音验证的“所引”映射为“索引”;用户确认 postgresql 是专有产品名后,可按完整词边界规范为 PostgreSQL。词典可以按项目启用,用户确认某次修正后,也可以生成新的词条。
风险同样具体。“缓存”和“缓冲”都可能正确,适合结合搭配给出候选。专业术语进入词典之后,也应设置词边界、上下文和优先级。一个词条应说明适用场景、修改对象以及如何撤销。
MacBERT4CSC 是面向中文拼写纠错的模型。项目说明其训练涉及 SIGHAN 和 Wang271K 中文纠错数据;模型卡报告的是相应中文拼写测试结果。将它接到语音输入后面,需要额外建立 ASR 错误与技术口述的评测集。MacBERT4CSC 项目说明、模型卡
它适合处理“今天新情很好”中“新”到“心”这类局部替换。语音识别还可能发生整词误认、遗漏、插入和跨语言误判,这些错误需要各自的处理办法。MacBERT4CSC 在产品中的职责可以收窄为:对可修改的中文位置提出等长字符替换候选。
模型仓库包含 ONNX 文件,ONNX Runtime 也提供 Windows CPU 的 C# 包。部署时仍需核对模型输入输出、分词器、特殊 token 和字符位置映射,再校验转换前后的输出一致性。直接接入 pycorrector 的示例则使用 Python、PyTorch 与 Transformers,适合开发验证。MacBERT4CSC ONNX 文件、ONNX Runtime C# 支持、pycorrector 实现
轻量 LLM 可以通过 llama.cpp 这类 C/C++ 推理工具在本地运行。llama.cpp 仓库 对自动输入而言,最值得约束的是输出权限:让模型返回候选区间、原字串与替换字串,随后检查来源匹配、保护范围、允许的编辑类型和最大编辑量。提示词表达意图,程序校验落实边界。
英文与中英混说:把字符保护落实到候选修改
在 ASR 后面加入 MacBERT4CSC,会影响最终呈现给用户的文本。中文模型对英文和技术符号的可靠程度需要单独验证;它处理的是已经生成的转写文本。
技术口述尤其容易出现这种输入:
把 PostgreSQL 的 cache_size 设为 256 MB,配置写到 C:\app\config.json。
这里同时包含产品名、代码标识符、数值、单位和路径。我的默认策略是保护英文片段,并把数字、URL、邮箱、路径、代码和用户指定术语一并标成保护区。高风险中文词也可以加入保护表,例如人名,以及“已经”“尚未”“可以”“禁止”等影响状态与权限判断的表达。
保护区需要基于原文保存位置和字串。模型读完整上下文后,应用只接受位于允许位置的候选编辑;较简单的实现也可以只处理独立中文片段,同时评估切段造成的上下文损失。占位符方案需要额外验证分词、语境和恢复位置。
具体接受条件可以收紧为四项:
- 原文区间与候选记录完全匹配,候选位置映射可追溯。
- 编辑区间全部位于允许修改的中文字符内,保护区逐字保留。
- 替换符合项目混淆表、词典或已验证的纠错条件,编辑量处于设定范围。
- 超时、位置异常或证据不足时,提交原始转写并保留候选供查看。
MacBERT 分词后的 token 与原始字符之间有映射关系。英文可能拆成子词,空格和特殊符号也有自己的处理方式;通过 token offset 对齐原文,能让保护规则真正落在正确位置。纯英文文本可以直接通过中文 CSC 层;英文纠错作为另一个按需启用的功能评估。
英文保护也需要区分处理阶段。用户确认的领域词典可以把“postgre sql”规范成 PostgreSQL;随后运行的通用中文 CSC 继续保留这个结果。这让术语修复与字符保护各自拥有清晰权限。
模型给出的高分代表其内部偏好,自动替换阈值需要通过领域数据校准。尤其在人名、金额和状态表达上,保留原文、提供候选通常更符合忠实输入的目标。
SenseVoice 的“热词支持”需要写明发生在哪里
热词这个名字覆盖了几种技术。它们对架构选择的影响很大,适合把“热词在哪里参与”写清楚。
解码时偏置发生在音频候选路径的搜索过程中。解码器提高目标词的得分,使声音相近时更容易选中用户关心的术语。文本后处理发生在识别结束之后,以显式映射或近似匹配修正现有文字。神经上下文增强则涉及带上下文建模能力的特定模型与推理实现。
截至本文核查日,基础 SenseVoice-Small 标准公开推理路径的原生 hotword biasing 支持状态为“未提供”。它的官方公开推理实现使用 CTC 输出和 greedy 取最大值、合并重复、移除 blank 的路径。当前 sherpa-onnx 的 SenseVoice 实现也将解码方式限定为 greedy_search。因此,这条标准集成路线应按“基础识别 + 应用侧术语处理”设计,原生 hotword biasing 的选型依据是所用实现明确提供的上下文解码能力。SenseVoice 推理源码、sherpa-onnx SenseVoice 实现
sherpa-onnx 官方热词文档把通用热词支持限定在 Transducer 模型的 modified_beam_search,覆盖流式与非流式模型。中文、英文及混合热词还需要匹配模型的 token 单位,例如字符、BPE 或两者组合。greedy Transducer、SenseVoice CTC、Paraformer、Whisper 等分支应分别核查自己的实现;配置对象出现 hotwords_file 字段,只说明公共接口提供该字段。sherpa-onnx 热词文档
其他模型分支可能提供自身的解码、上下文或提示机制。工程上应记录“模型名称 + 运行库版本 + 解码方式 + 生效参数”,再用含热词和普通词的对照录音确认效果。这样,识别框架的功能描述才能落到实际产品配置。
官方 FunASR 后处理热词
当前 FunASR 的官方 API 文档明确提供 postprocess_hotwords、postprocess_hotword_file 等参数,用于解码后的文本级热词修正。文本文件支持目标词和“错误词=>目标词”显式映射。FunASR API 文档
对应源码实现了显式替换,以及使用拼音与模糊相似度的候选匹配;它修改文本字段,并保留原始识别的时间戳。对于依赖字词对齐的功能,应用应处理修正文本与原时间戳之间的关系。FunASR 后处理热词源码
这是一套可以借鉴的官方文本修正能力。Windows 运行时免 Python 的应用可在 C# 或 C++ 中实现经过筛选的映射与匹配逻辑。此时,纠错职责和资源消耗都在应用侧。发布产品应固定已经核实的版本或提交,实际确认这些参数存在,并把新增功能单独回归。
第三方 SenseVoice 热词解码改造
pengzhendong/streaming-sensevoice 展示了另一条路径:从 SenseVoice 获取 CTC 概率,用携带 contexts 的解码器执行 CTC prefix beam search。源码中,提供上下文且 beam 大于 1 时启用该路径。这属于读取声学候选后进行的解码改造。第三方实现源码
这个项目当前还导入 PyTorch 和 FunASR。采用它时,免 Python/PyTorch 的 Windows 目标需要额外的移植工作,包括概率输出、token 一致性、上下文评分和解码性能验证。分块或历史截断也会影响识别行为,应该和热词收益分别测量。
SenseVoice 官方仓库的第三方工作列表还列出了社区 dengcunqin/SenseVoiceSmall_hotword,描述为神经网络热词增强。这说明 SenseVoice 生态中存在专门的增强方案;采用时要核查那个模型的权重、代码、许可和部署路径。SenseVoice 第三方工作列表
我的建议是按需求强度推进:普通桌面口述先用基础 SenseVoice 与保守术语词典;大量专有名词需要在声学搜索阶段获得帮助时,优先评估已有热词支持的 Transducer;领域收益足够大时,再投入 SenseVoice 上下文解码或专门增强模型的移植与验证。
用“正确内容保持正确”衡量输入质量
一个纠错层的价值,取决于它修好了多少错误,以及给正确文本新增了多少错误。用户看到自动提交的文字,通常会把它当作自己的输入;悄悄改变一个产品名、数字或状态词,代价可能远高于留下一个普通错字。
评测应同时记录原始 ASR 的中文 CER(字符错误率)、英文 WER(词错误率),以及修正后的整体错误变化。对纠错层,至少跟踪实际修改的正确率、正确文本被误改的比例、术语与数字完整率。对产品体验,再记录松手到提交的 P95 延迟、取消与撤销是否完整,以及目标窗口是否准确。
测试材料最好覆盖纯中文、纯英文、中英混说、代码口述、陌生人名、长句、自我更正和背景噪声。每条保留“音频、用户希望得到的文本、ASR 原文、最终输出、修改记录”。目标文本由产品的忠实输入策略确定,方便区分识别错误和编辑行为。
实际启动项目时,我会先交付按住说话与切换录音、SenseVoice 本地识别、项目词典、字符保护和整次撤销。接着用真实录音找出剩余错误,再决定 CSC 是否值得加入。让每一次自动修改都有依据,让用户松开按键后可以放心继续写,语音输入才会成为可靠的键盘延伸。