TimesFM-3 实用指南:预测什么、怎样接入应用、如何选择部署方案
用冰淇淋补货案例理解时间序列基础模型,比较它与大语言模型的分工,梳理实际应用、零样本验证、云端与本地接入、硬件预算和当前许可。附原创说明图及官方来源。
TimesFM-3 实用指南:预测什么、怎样接入应用、如何选择部署方案
作者:Ha Fung
资料核实日期:2026年10月8日
一家门店准备安排下个月的冰淇淋促销。采购负责人需要知道每天大概卖多少、活动当天应多备多少货,以及销量超过预期时留多少缓冲。
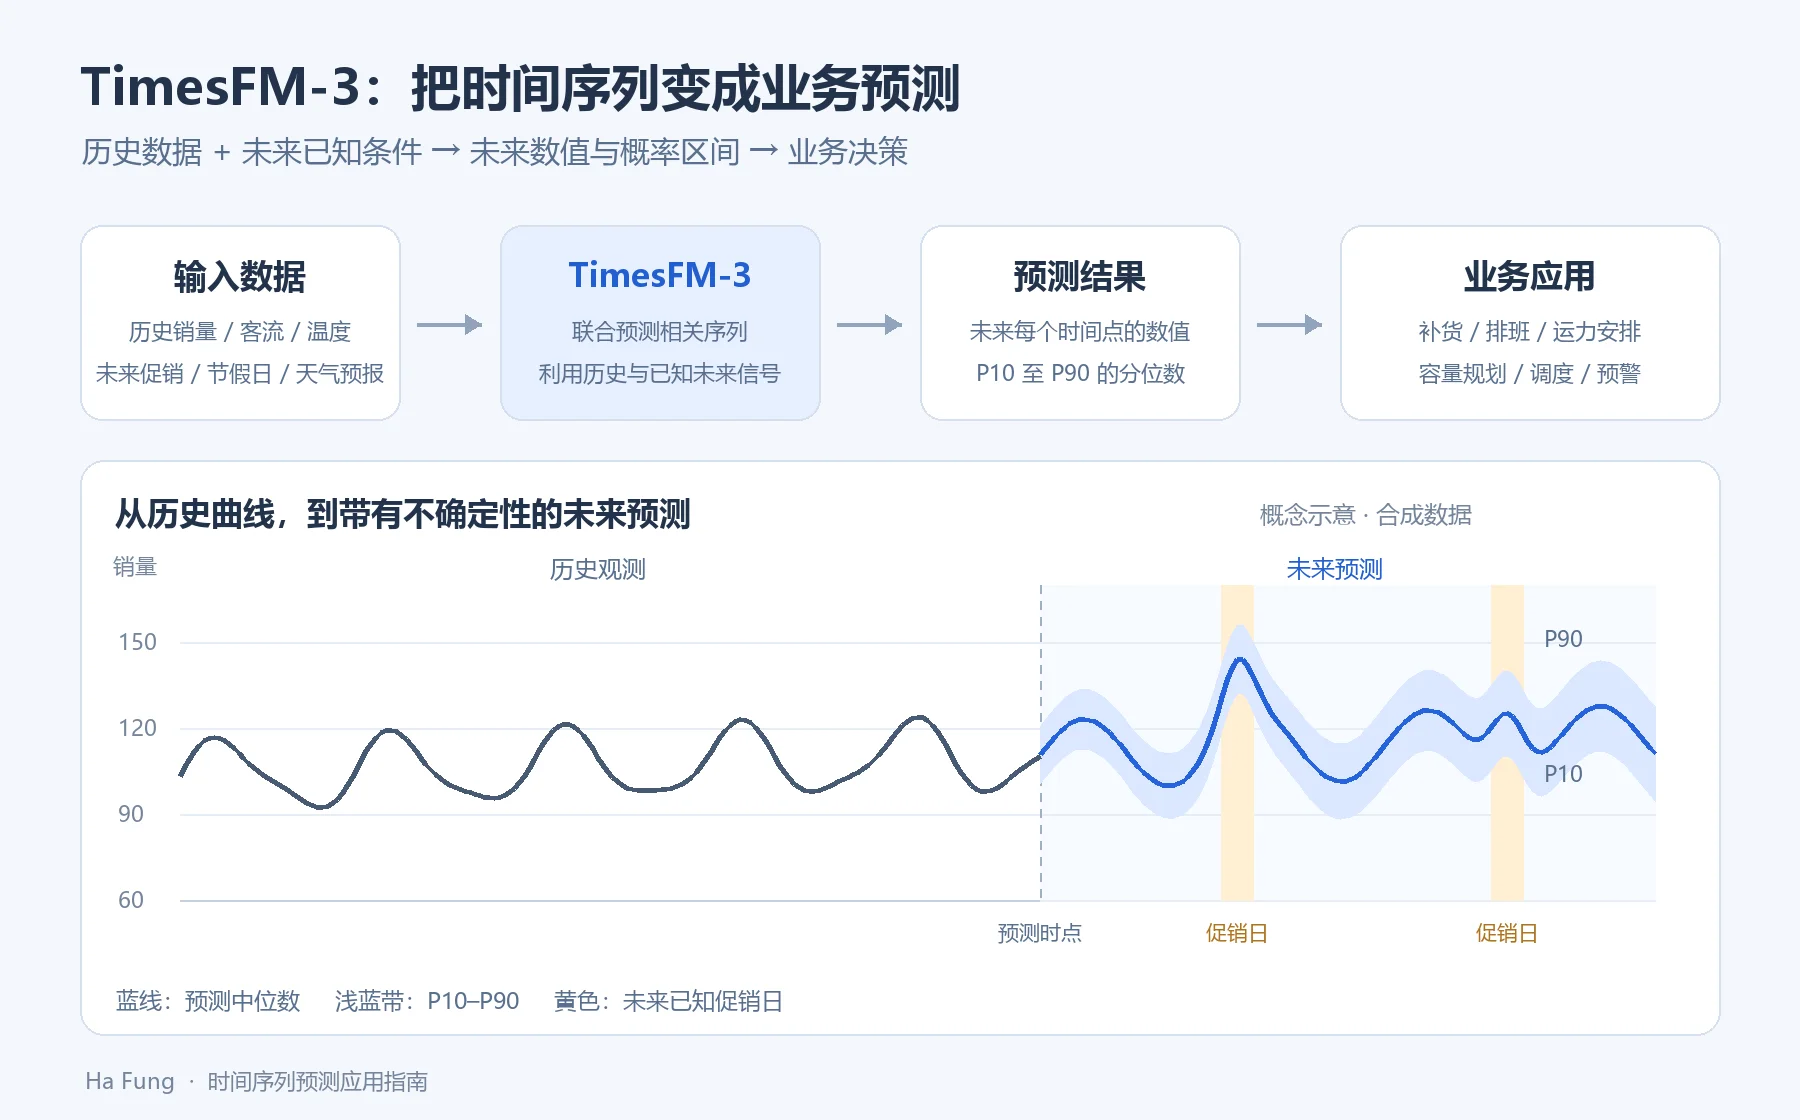
TimesFM-3 就适合进入这样的流程:把历史销量、相关商品销量、客流和未来促销日历交给模型,获得未来每天的数值预测,再把结果用于补货与排班。选用这类模型,最有价值的起点是一个可以衡量成本的业务决策。

原创概念图,曲线采用合成数据,用于解释输入、预测区间与业务应用的关系。
时间序列基础模型究竟预测什么
时间序列就是按时间排列的数值:每日销量、每小时用电量、每分钟服务器请求量,以及每秒设备温度都属于这类数据。“基础模型”表示它已经在大量数据上学习过通用模式,可以把这些模式迁移到新任务。
Google 在2026年8月发布 TimesFM-3,介绍其拥有约3.3亿参数,预训练数据超过1万亿个时间点。它支持多目标联合预测,也能接收历史辅助变量和覆盖历史、未来的已知变量。发布文章展示了促销日销量上升的例子,并报告其在三个公开基准中取得领先的平均排名。Google Research 发布说明
把这些能力放到门店里,可以分成三组输入:
- 目标序列:几种冰淇淋、甜筒和糖浆的每日销量,模型同时预测它们。
- 历史辅助变量:过去的客流、成交笔数等,帮助解释历史变化。
- 历史及未来变量:促销、节假日、计划价格和天气预报,帮助预测未来变化。
未来天气这类输入,应采用预测当时能取得的预报版本。历史回测也应保留当时的数据条件,才能接近真实上线表现。
模型输出包括未来数值和分位数。例如,某一天的 P50 销量为100件,P90 为140件,采购者就能按照缺货成本选择备货水平。这里的数字是说明用的假设。各分位数的实际覆盖率,应在自己的业务数据上校验。
多条序列之间的联系也需要经过验证。给模型加入相关商品、天气和促销,可能提高准确率;新增变量的效果由回测来判断。促销条件下的销量预测用于估计需求,促销的因果效果则需要实验或专门的因果分析来确定。
它和大语言模型怎样分工
两者都可以采用 Transformer,也都先经过预训练。它们学习的数据、输出形式和任务目标各有侧重。
| 比较项 | TimesFM-3 | 大语言模型 |
|---|---|---|
| 主要输入 | 按时间对齐的数值序列、辅助变量 | 文本、代码,以及模型支持的其他模态 |
| 数据单位 | 一组连续时间点形成的数据块 | 文本 Token 等 |
| 主要输出 | 未来数值、分位数预测 | 自然语言、代码、结构化内容 |
| 适合承担的工作 | 需求、负载、能耗等数值预测 | 理解需求、组织流程、解释结果 |
在一个智能采购应用里,两者可以协作。用户说“帮我安排下个月的补货”,语言模型负责理解商品范围、调用数据接口和预测工具;TimesFM-3 负责计算未来需求;补货程序结合库存、供应周期、最小起订量和预算生成订单;语言模型再把建议与依据解释给用户。
这样,用户用自然语言操作应用,后台用专门的预测模型处理数值。大语言模型可以通过工具使用预测结果,应用则应为结果提供可追溯的数据和计算来源。
哪些场景值得投入
门店补货是一个容易理解的起点,因为预测结果对应明确的损失:库存过多会占用资金或产生损耗,库存过少会失去销售机会。其他适合试验的场景也有类似结构。
| 场景 | 可以联合预测的指标 | 预测支持的行动 |
|---|---|---|
| 零售、电商与供应链 | 商品销量、订单量、仓库吞吐量、线路需求 | 采购、调拨、运力和排班 |
| 云服务与互联网系统 | 请求量、CPU、内存、带宽、延迟 | 提前扩容、安排容量和告警 |
| 制造与设备运维 | 温度、压力、振动、产量、能耗 | 排产、维护安排、异常预警 |
| 能源与城市交通 | 电力负荷、风光发电、道路流量、公共交通客流 | 储能与调度、车辆和班次配置 |
金融经营可以从现金流、支付量和流动性需求入手;医院运营可以预测急诊量、床位占用和药品消耗;科研与环境监测可以研究河流水位、空气质量和多传感器读数。这些是基于多变量预测能力推导的应用方向,具体效果需要各领域数据验证。
每个场景都应把预测接到下一步动作。例如,设备指标超出预测区间后,维护系统需要进一步判断设备工况和告警原因;医院的人员配置需要结合服务规则与专业审核。预测提供未来状态的估计,决策程序把估计转化为行动。
优先选择三项条件齐备的任务:有连续历史数据,有提前行动的时间,有能计算的预测失误成本。
自己需要做哪些训练和验证
通常可以直接加载预训练权重,输入自己的历史数据并运行预测。这就是零样本使用:新增业务任务的第一轮试验直接从推理开始。
业务数据仍然重要。它既提供本次预测的历史背景,也用于衡量模型是否值得上线。一个稳妥的试验顺序是:
- 选定一个目标,例如预测某商品未来14天的每日需求。
- 选择多个过去的日期作为预测时点,每次只使用当时可取得的数据。
- 将结果与季节性基线、现有系统或其他预测模型比较。
- 同时计算预测误差、缺货率、积压成本和推理耗时。
季节性基线可以很简单,例如“下周一的销量采用上周一的销量”。新模型取得的提升,需要足以覆盖接入、运行和维护成本。
后续优化从补充有效变量、修正缺失值和调整相关序列分组开始。任务需要进一步适配时,再评估当前版本的微调支持、领域模型或模型组合。Google 在仓库中提供过2.5版本的微调例子,采用3.0时应逐项核对对应代码和权重支持。官方仓库与版本说明
数据准备通常占据大量工作。时间粒度要统一,商品与门店标识要清楚,还要正确处理缺失和断货。断货期间的销量反映了库存限制,需求估计需要结合库存状态处理。
接入应用:先选云端还是本地试验
截至2026年10月8日,TimesFM-3 已有两条重要使用路径。
通过 BigQuery 接入。 对已经使用 Google Cloud、准备做商业或生产应用的团队,这条路径值得优先评估。预测通过 SQL 发起,由云端管理模型运行。Google Cloud 文档明确允许通过 BigQuery 商业使用;TimesFM 3.0 及其多变量功能当前标记为 Preview,选型时应结合对应服务条款和支持范围。BigQuery TimesFM 文档
下面是两个销量目标的接入示例,表名和字段需要替换成自己的数据:
SELECT *
FROM AI.FORECAST(
  TABLE `myproject.mydataset.daily_sales`,
  target_cols => ['ice_cream_sales', 'cone_sales'],
  timestamp_col => 'sales_date',
  model => 'TimesFM 3.0',
  horizon => 14
);
计划促销和节假日可以作为未来协变量加入。准备这类输入时,需要为相应未来日期提供已知值,并按文档处理未来目标列和历史协变量的空值。当前云端接口支持的3.0上下文最多为2048个时间点,预测跨度最多为1024个时间点;云服务参数应以该接口文档为准。AI.FORECAST 参数与示例
下载权重做本地研究与试验。 这条路径适合检查数据、研究模型表现和测量硬件成本。TimesFM-3 的公开权重采用非商业、非生产许可;源代码和2.5及以前版本权重采用 Apache-2.0。自行部署3.0权重与调用授权云服务,各自适用对应许可。官方许可说明
本地试验可使用 Python 3.10及以上版本,安装 PyTorch 依赖。官方当前仓库的安装入口如下:项目依赖配置
pip install "timesfm[torch]"
下面的例子采用合成数据演示接口,需要 CUDA 可用的环境。运行时会取得相应模型权重:
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

model = TimesFM3Evaluator(
    ModelConfig(
        checkpoint_path="google/timesfm-3.0-pytorch",
        per_core_batch_size=1,
        device="cuda",
    )
)

# 演示数据:128个历史时间点,预测未来14个时间点。
history = (
    100 + 15 * np.sin(np.arange(128) * 2 * np.pi / 7)
).astype(np.float32)

result = next(
    model.predict_batch(
        contexts=[history],
        horizon=14,
        return_quantiles=True,
        use_symmetric_averaging=False,
    )
)

print(result.forecast.shape)   # (14,)
print(result.quantiles.shape)  # (14, 9)
多变量目标使用“目标数量 × 历史长度”的数组;历史辅助变量使用自己的通道;历史及未来变量则覆盖“历史长度 + 预测长度”。开发时按当前版本的完整示例核对数组与时间对齐关系。官方多变量调用示例
应用里可以安排定时任务,读数据、运行预测、写回结果,再由仪表盘或补货系统读取。需要即时交互时,可把推理封装为内部服务,提前加载模型并控制请求批次。每天一次的补货通常适合批量任务,交互式情景试算则需要重点测量响应时间。
普通电脑能跑到什么程度
TimesFM-3 的公开模型卡标记权重为 F32。按约3.3亿参数、每个参数4字节计算,纯参数存储量约为1.32GB,这是按参数规模得到的估算。实际运行还会使用模型加载缓冲、激活值、输入输出和框架内存。官方模型卡
硬件选择应从实际数据批次开始。可以把16GB系统内存、8GB显存的 NVIDIA GPU 作为小规模试验的预算参考,在短历史、小批次、少量变量的条件下测量峰值内存和耗时。这是工程试验建议,硬件下限与吞吐保证需要结合具体工作负载确定。
CPU 路径适合评估低频、小批次任务,具体速度由处理器和输入规模决定。Apple Silicon 用户也可以考察当前仓库提供的 MLX 后端。官方仓库提供了特定 M4 Max 配置的测量数据,这些数字用于了解该配置的表现。当前后端与示例
影响资源消耗的关键因素有四项:一次处理的任务数量、每个任务的目标及辅助变量数、历史窗口长度、预测跨度。遇到内存压力时,优先缩小批次、缩短历史窗口,并按业务关系拆分序列组。模型参数量只是预算的一部分。
采用 BigQuery 时,本地设备承担数据处理和请求调用,模型计算资源由云端提供。预算关注点随之转向查询量、数据量、服务计费和数据所在区域。
从一个可衡量的任务开始
建议先选一个商品、一类设备或一组服务器指标,固定预测跨度,使用多个历史窗口测试。试验记录里同时保留预测误差、区间覆盖率、运行成本和业务损失。
当结果支持上线,再决定云端服务、调度频率和业务规则。TimesFM-3 的实际价值,会体现在更合适的库存、更及时的容量安排,以及更有依据的人员与资源配置上。