ACE-Step 1.5 本地运行指南:架构、GGUF、Windows 纯 CPU 与 i5-14600K 评估
从 LM 规划、DiT 合成与 VAE 解码理解 ACE-Step 1.5,核对官方 PyTorch 与社区 acestep.cpp/GGUF 两条部署路线,给出 Windows 纯 CPU 安装命令,并评估 i5-14600K、32GB RAM 与 UHD 770 的运行条件、参数选择及测速方法。
ACE-Step 1.5 本地运行指南:架构、GGUF、Windows 纯 CPU 与 i5-14600K 评估
作者:Ha Fung
资料核实日期:2026 年 10 月 21 日
i5-14600K、32GB RAM、UHD 770 的 Windows 电脑,适合把 ACE-Step 1.5 当作本地音乐生成实验台。建议从普通 2B Turbo、单条 10–30 秒音频开始:优先尝试社区的 acestep.cpp 纯 CPU 方案,需要官方编辑界面时使用 Python/PyTorch 方案。实际生成耗时、长音频内存峰值和可接受的创作节奏,需要由目标机器的首轮测量确定。
这个判断来自模型结构、软件支持与硬件条件的交叉核对。本文提供公开资料评估和可执行的安装步骤;本机模型推理与速度测量留作安装后的验收环节。
从一段配乐需求,看清它能做什么
例如,为一段夜景视频生成 30 秒配乐:输入“温暖的电钢琴、轻鼓点、夜间城市氛围”,指定 90 BPM、纯音乐和时长,ACE-Step 就能按这些条件合成音频。有歌词时,可以继续提供段落标记和演唱语言;已有音频时,可以进入参考、翻唱或局部重绘任务。
官方实现覆盖文本生成音乐、参考音频、Cover、Repaint、元数据控制、音频理解,以及 LoRA 个性化训练。项目还列出声部分离、增添声部和补全编曲等任务。**选择具体模型时,要同时检查任务支持表。**普通 Turbo 支持文本生成、参考、Cover 与 Repaint;Extract、Lego、Complete 对应的完整任务支持集中在 base 系列。官方界面与任务支持说明
官方标示的生成范围达到 10 秒至 600 秒,并提供多语言歌词支持。这些数字描述系统的功能范围。落到一台电脑上,时长上限还受模型、内存和启动配置约束。CPU 入门时,短片段最容易让人看清提示词、音色、歌词与等待时间之间的关系。官方功能说明
LM 规划、DiT 合成、VAE 还原:计算花在哪里
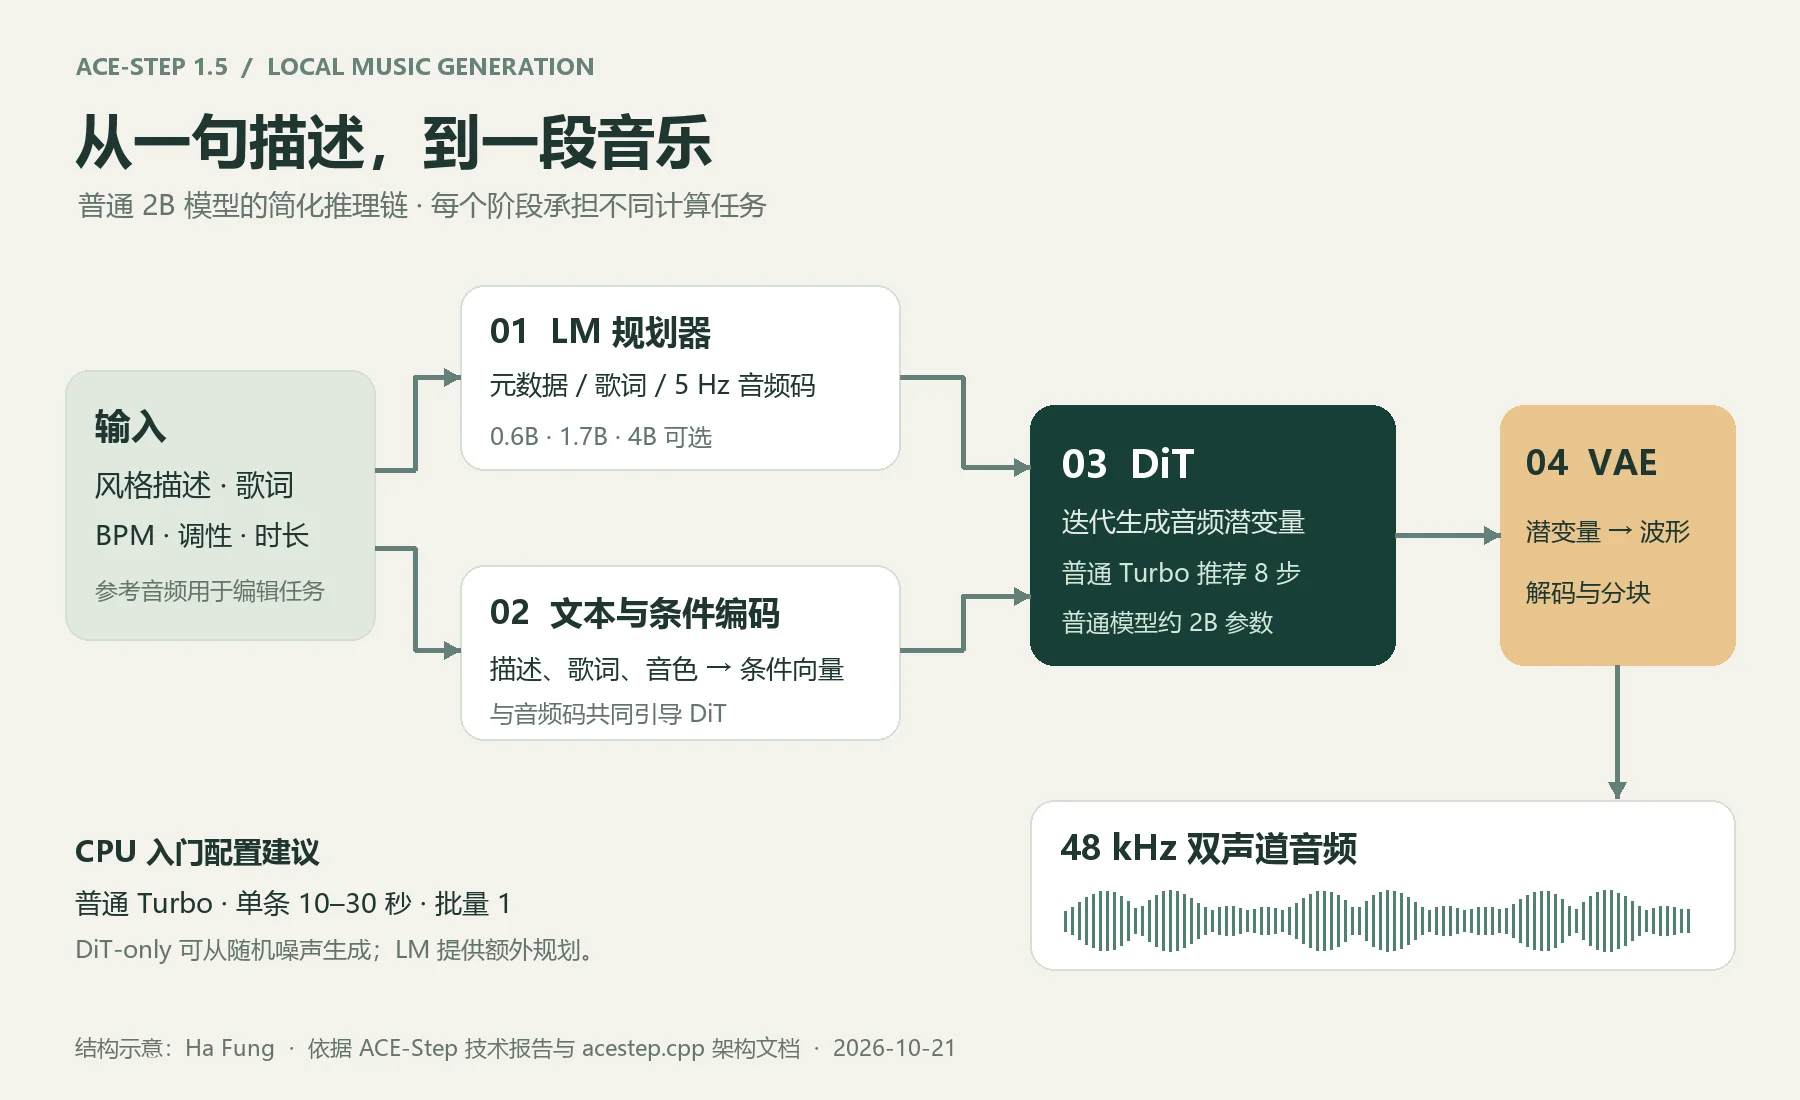
ACE-Step 1.5 把音乐规划与声学合成分给不同模块。理解这条链路,才能判断升级哪一部分有用。

图:Ha Fung 根据官方技术报告与 acestep.cpp 架构文档绘制。箭头表示主要条件与数据流,参考音频的编码支路在图中作了简化。
**LM 负责规划。**Qwen 系列语言模型可以补全 BPM、调性、歌词等信息,并生成每秒约 5 个离散音频码。按这个码率,三分钟音频约对应 900 个音频码,另有文本与元数据的上下文开销。较长音乐会增加自回归生成的工作量。
**文本与条件编码器负责“读懂要求”。**描述、歌词、音色等信息被转换为条件向量,供声学模型使用。LM 与文本编码器分别承担规划和条件表达,部署时应核对各自的模型文件。
**DiT 负责合成音频潜变量。**普通版本约为 2B 参数;潜变量是一种压缩后的音频表示。官方技术报告描述了局部滑动窗口注意力与全局分组查询注意力交替使用的结构,让模型同时处理局部声音细节和较长范围的音乐关系。FSQ 模块连接 25 Hz 连续潜变量与 5 Hz 离散音频码。技术报告第 3 节
**VAE 负责把潜变量解码成波形。**因此,一次生成的总时间包含规划、条件编码、DiT 迭代、VAE 解码和文件保存。即使 DiT 只跑少量步数,长音频的解码与内存开销也值得单独观察。推理阶段与实现细节
官方支持 DiT-only:关闭 LM 后,保留文本条件和声学生成,适合先建立短音频基线。启用 LM 后,可以进一步比较自动补全、音频码规划对作品结构的影响。官方 CPU 模式说明
“4B”要对应到具体模块,参数也要跟随模型
模型名中的数字需要连同所属模块一起看。
| 模块或版本 | 含义 | 这台电脑的起步选择 |
|---|---|---|
| 普通 DiT,约 2B | 声学合成主干;提供 base、sft、turbo 等变体 | 普通 acestep-v15-turbo |
| XL DiT,4B | 更大的声学主干 | 留到普通模型测量完成后评估 |
| LM,0.6B / 1.7B / 4B | 可选的音乐规划模型 | DiT-only 起步,随后加入 0.6B |
| 文本编码器与 VAE | 条件编码和音频还原 | 使用所选实现配套文件 |
官方模型表把普通 Turbo 的推荐步数列为 8,base 和 sft 列为 50。8 步减少的是声学模型的迭代次数;端到端耗时还包含其余阶段。XL 属于更重的选择,官方给出的 GPU 部署条件包括卸载、量化及更高显存预算。官方模型选择与 XL 说明
Python 推理接口中还有一个容易影响结果的细节:Turbo 使用蒸馏后的引导,流水线把 guidance_scale 校正为 1.0;官方文档建议 Turbo 设置 shift=3.0,该项需要调用者明确处理。base/SFT 则有自己的 CFG 参数范围。通过不同界面或 C++ 实现调用时,应采用对应版本的参数定义。官方推理参数说明
对 CPU 入门而言,最有用的四个起始值是:普通 Turbo、8 步、批量 1、10–30 秒。固定 seed 后,每次只改一项设置,才能看清改变来自哪里。
性能声明怎样落到这台电脑上
官方 README 声称,完整歌曲在 A100 上可低于 2 秒,在 RTX 3090 上可低于 10 秒;同页也说明耗时随思考模式和扩散步数变化。这些属于项目在 GPU 条件下给出的性能声明,读者需要连同硬件、时长、模型与计时范围理解。官方性能声明
i5-14600K 的耗时应通过本机测量建立。可以把一次生成拆成下面这个账本:
总耗时 = 模型加载 + LM 规划 + 条件编码 + DiT 迭代 + VAE 解码 + 音频保存
首次运行常包含下载、加载和初始化。第二次同配置生成更适合观察稳定等待时间。官方 profiler 可以分别统计 LM、DiT、VAE 与总耗时;文档将 CPU 路线定位为较慢的测试用途。官方性能分析指南
比较不同机器时,可记录实时系数 RTF = 生成耗时 / 音频时长。例如,假设生成 30 秒音频花了 180 秒,RTF 就是 6。这里的数字仅用于演示计算方法。评估日常可用性时,还应记录一次成功生成的峰值内存,以及为了得到满意片段需要尝试多少次。
acestep.cpp:把完整音乐链放进 C++ 与 GGUF
ServeurpersoCom/acestep.cpp 是社区维护的 C++17/GGML 实现;ace-step/ACE-Step-1.5 是官方 Python 仓库。两者应分别记录版本、参数和功能覆盖。
C++ 路线把音乐规划、声学合成与音频解码接入 GGML 后端,并提供浏览器界面和服务器。GGUF 用于保存模型张量及运行所需的元数据。项目支持 CPU,并提供 CUDA、Metal、Vulkan 等后端,具体可用设备取决于编译选项、驱动与算子支持。acestep.cpp 使用说明
量化后的文件可以减少权重存储和数据搬运需求。Q8_0、Q6_K、Q4_K_M 等格式代表不同的存储与计算取舍,实际速度与输出质量需要在目标后端测量。对于 32GB RAM,先使用普通 Turbo 的 Q8_0 配套文件,有利于建立较清楚的质量基线。
完整的标准链需要核对四类文件:
| 文件 | 作用 |
|---|---|
acestep-5Hz-lm-0.6B-Q8_0.gguf | 轻量 LM 规划器 |
Qwen3-Embedding-0.6B-Q8_0.gguf | 文本编码器 |
acestep-v15-turbo-Q8_0.gguf | 普通 Turbo 声学模型与配套条件组件 |
vae-BF16.gguf | 音频编解码器 |
这些文件可以在项目维护者的 GGUF 模型目录 中逐一核对。该目录显示,0.6B LM Q8_0 约 710 MB、文本编码器 Q8_0 约 784 MB、普通 Turbo Q8_0 约 2.55 GB;文件大小会受单位和版本影响。运行时还需要 KV cache、激活值、音频缓冲和操作系统内存,预算应以实际工作集为准。
对本配置,我推荐先试 C++ CPU 路线:依赖集中,设备选择明确,量化模型便于管理。需要官方 Gradio 中的完整工作流和训练入口时,再使用 Python 环境。两条路线都保留版本记录,便于复现。
Windows 纯 CPU 安装:从源码构建 acestep.cpp
以下步骤使用 PowerShell,面向 Windows x64。准备 Git、Visual Studio 2022 Build Tools,勾选“使用 C++ 的桌面开发”,并安装 CMake 工具。编译使用 MSVC;推理使用 CPU 后端。这里给出的是基于仓库构建定义与命令行接口整理的方案,首次编译和首次音频生成构成本机验收。Windows 构建文档、CMake 构建定义
1. 获取源码并固定版本
在准备存放项目的目录运行:
git clone --recurse-submodules https://github.com/ServeurpersoCom/acestep.cpp.git
Set-Location acestep.cpp
git checkout de858d8e1a94f0e1939cf9bdd8ff7d9631953077
git submodule update --init --recursive
git rev-parse HEAD
本文核对的 C++ 提交为 de858d8。固定提交后,子模块也随该版本更新;日志里保留完整 SHA,后续比较速度或排查问题会更准确。
2. 构建 CPU 服务器
cmake -S . -B build-cpu -G "Visual Studio 17 2022" -A x64 -DGGML_CPU=ON -DGGML_CUDA=OFF -DGGML_VULKAN=OFF -DGGML_METAL=OFF -DGGML_SYCL=OFF
cmake --build build-cpu --config Release --target ace-server --parallel 8
这组设置把推理构建限定在 CPU。--parallel 8 控制编译并行度,推理线程由运行后端处理。Visual Studio 安装版本和 CMake generator 应保持对应关系。
3. 放入四个模型
New-Item -ItemType Directory -Force models | Out-Null
打开上文 GGUF 模型目录,下载表中的四个文件,保留完整文件名,放入项目的 models 目录。使用 0.6B LM 起步,能控制规划阶段的模型规模。模型目录只保留本次要使用的组合,也有助于确认界面选中了哪个版本。
4. 明确选择 CPU 并启动
.\build-cpu\Release\ace-server.exe --models .\models --device CPU --host 127.0.0.1 --port 8085 --max-batch 1
浏览器打开 http://127.0.0.1:8085。命令显式指定了设备、地址和端口,便于按日志核对。--max-batch 1 是 LM 批量上限;界面中的生成数量也设置为 1。项目 README 的启动脚本采用 8085,服务器选项表列出的默认端口为 8080,因此保留这个显式端口设置。服务器参数
第一次生成选普通 Turbo、8 步、10 秒、纯音乐,描述可用:
Warm electric piano, gentle drums, mellow bass,
night city atmosphere, instrumental, 90 BPM.
歌词栏使用项目文档约定的 [Instrumental]。记录日志中的实际设备、模型名、生成耗时与内存峰值,确认音频文件可以播放。随后使用相同设置生成 30 秒,再加入歌词或增加 LM 规模。生成模式与纯音乐约定
官方 Python 方案:使用完整 UI,在 CPU 上推理
官方支持 Python 3.11–3.12,并提供 uv 安装入口。安装 uv 后,在项目目录执行:
git clone https://github.com/ace-step/ACE-Step-1.5.git
Set-Location ACE-Step-1.5
uv sync --python 3.11
需要先安装 uv 时,官方文档给出的 Windows 命令为:
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"
安装完成后重新打开终端,再继续项目步骤。官方安装指南
**这条路线采用官方依赖集合,并把执行设备设为 CPU。**核查时,Windows 的 pyproject.toml 固定了 torch==2.7.1+cu128、配套 torchvision 与 torchaudio。因此,磁盘和下载预算需要包含 CUDA 版依赖;CPU 推理由启动参数控制。希望采用精简纯 CPU 运行依赖的读者,可以优先使用上一节的 C++ 方案。官方依赖声明
从 DiT-only 启动:
$env:ACESTEP_INIT_LLM = "false"
uv run acestep --device cpu --backend pt --init_service true --init_llm false --config_path acestep-v15-turbo --batch_size 1 --use_flash_attention false --language zh
打开 http://127.0.0.1:7860。模型会在首次需要时下载。检查启动日志中的 CPU 设备,并在生成界面关闭 LM 思考、设批量 1、短时长和 Turbo 对应步数。启动参数源码
短音频基线完成后,再比较 0.6B LM:
$env:ACESTEP_INIT_LLM = "true"
uv run acestep --device cpu --backend pt --init_service true --init_llm true --lm_model_path acestep-5Hz-lm-0.6B --config_path acestep-v15-turbo --batch_size 1 --use_flash_attention false --language zh
offload_to_cpu 描述 GPU 工作流中的模型卸载。纯 CPU 执行的直接控制项是 --device cpu。GPU 显存分档、INT8 配置和 CPU 推理设置各有对应条件,调参时应跟随当前设备与实现。
i5-14600K、32GB、UHD 770 的可行性边界
i5-14600K 配备 6 个性能核、8 个能效核和 20 线程,支持 AVX2,集显为 UHD 770。这些条件支持把 x64 CPU 推理作为可行的实验方向。CPU 的实际吞吐还受内存带宽、散热、后端实现与线程调度影响。Intel 14 代桌面处理器资料、14600K 核心与线程规格
32GB RAM 为普通 2B Turbo、单条短音频提供了合理的尝试条件。长音频、较大 LM、XL、批量生成和高峰解码会继续增加工作集。安装时同时准备 SSD 空间:官方列出的核心模型约 10GB,Python 环境、下载缓存、C++ 构建目录和生成文件需要额外预算。官方资源要求
UHD 770 的角色需要按后端分别判断:
| 路线 | 已核实依据 | 本配置的行动建议 |
|---|---|---|
| CPU | 官方支持 CPU 推理;C++ 提供 CPU 设备选择 | 作为首选基线 |
| PyTorch Intel XPU | 官方安装文档记录的测试机为 Core Ultra 9 285H 集显;PyTorch 验证列表主要覆盖 Arc 与 Core Ultra Arc 系列 | UHD 770 的支持与表现留待单独验证 |
| C++ Vulkan | 项目提供 AMD/Intel 的 Vulkan 构建路线 | CPU 基线完成后,以日志与计时验证 UHD 770 |
依据:ACE-Step Intel GPU 测试条件、PyTorch XPU 硬件验证列表、C++ Vulkan 构建入口。
共享系统内存的集显拥有自己的算力和带宽约束。判断加速收益,需要观察整条生成链的完成时间、稳定性和内存占用。将 Vulkan 设为第二阶段实验,可以让 CPU 的测量结果成为清晰的参照。
我对这套配置的建议是:**用于本地部署学习、短配乐和提示词实验;日常创作频率由首次测量决定。**长歌曲多轮筛选和 LoRA 训练适合在 GPU 条件下另做资源评估。
用第一段 10 秒音频决定后续投入
安装后的第一份记录应包含这些项目:
- 保存仓库 SHA、模型完整文件名、后端与设备日志。
- 固定 seed,普通 Turbo、8 步、批量 1,生成 10 秒纯音乐。
- 分别记录首次与后续生成耗时、峰值 RAM,以及 LM、DiT、VAE 的阶段时间。
- 扩到 30 秒,并用同一配置比较 DiT-only 与 0.6B LM。
官方 Python 环境可用 profiler 检查一个短任务:
uv run python profile_inference.py --device cpu --lm-backend pt --duration 10 --batch-size 1 --inference-steps 8
执行前查看该版本的 --help 和启动日志,确认模型及 LM 思考设置;记录时注明 profiler 的预热行为。C++ 环境则保存服务器日志与操作系统内存观测结果。Profiler 实现与参数
先得到一段可以播放、耗时和内存都有记录的短音乐。用这份结果决定延长到一分钟、升级规划模型,或转向 GPU,后续每一步投入都会有明确依据。